
最近总结了一套阿里云的面试题, 其中有一个ThreadLocal和线程池配合使用造成内存泄露的问题. 当时写了答案但是感觉对于ThreadLocal的理解还不是特别深入, 所以想再看一下源码.
一. ThreadLocal的简介
ThreadLocal介绍
ThreadLocal望文生义,简单解释就是线程的本地变量
JDK对它的定义:
该类提供了线程局部 (thread-local) 变量。这些变量不同于它们的普通对应物,因为访问某个变量(通过其
get或set方法)的每个线程都有自己的局部变量,它独立于变量的初始化副本。ThreadLocal实例通常是类中的 private static 字段,它们希望将状态与某一个线程(例如,用户 ID 或事务 ID)相关联
从这段解释中可以看出它是实现线程安全的一种新的方式,不同于以前加锁synchronized的方式, 每个线程都有自己的独立的变量,这样他们之间是互不影响的,这样就间接的解决线程安全的问题。举个通俗的例子,相当于由以前的贫穷年代,大家哄抢一块蛋糕,到现在的物质丰盛年代,每个人都有一块自己的蛋糕,大家互不影响,就不会存在争抢的情况
评价:
ThreadLocal解决了线程局部变量统一定义问题,多线程数据不能共享。(InheritableThreadLocal特例除外)不能解决并发问题
解决了:基于类级别的变量定义,每一个线程单独维护自己线程内的变量值(存、取、删的功能)
ThreadLocal的构造方法
1 | /** |
评价:
构造方法比较简单, 一个是默认的空的构造方法, 另一个是JDK 1.8之后加入的通过Supplier(实际上也是Lambda表达式)构造.
下面给出一个通过Supplier创建ThreadLocal的例子:
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
* ThreadLocal的Lambda构造方式: withInitial
*
* @author zk
*/
>public class ThreadLocalWithInitial {
/**
* 运行入口
*
* @param args 运行参数
*/
public static void main(String[] args) throws InterruptedException {
System.out.println("Safe deposit");
safeDeposit();
Thread.sleep(1000);
System.out.println();
System.out.println("Not safe deposit");
notSafeDeposit();
}
/**
* 线程安全的存款
*/
private static void safeDeposit() {
SafeBank bank = new SafeBank();
Thread thread1 = new Thread(() -> bank.deposit(200), "Jasonkay");
Thread thread2 = new Thread(() -> bank.deposit(200), "马云");
Thread thread3 = new Thread(() -> bank.deposit(500), "马化腾");
thread1.start();
thread2.start();
thread3.start();
}
/**
* 非线程安全的存款
*/
private static void notSafeDeposit() {
NotSafeBank bank = new NotSafeBank();
Thread thread1 = new Thread(() -> bank.deposit(200), "Jasonkay");
Thread thread2 = new Thread(() -> bank.deposit(200), "马云");
Thread thread3 = new Thread(() -> bank.deposit(500), "马化腾");
thread1.start();
thread2.start();
thread3.start();
}
>}
>class NotSafeBank {
/**
* 当前余额
*/
private int balance = 1000;
/**
* 存款
*
* @param money 存款金额
*/
public void deposit(int money) {
String threadName = Thread.currentThread().getName();
System.out.println(threadName + " -> 当前账户余额为:" + this.balance);
this.balance += money;
System.out.println(threadName + " -> 存入 " + money + " 后,当前账户余额为:" + this.balance);
}
>}
>/**
* 线程安全的银行
*/
>class SafeBank {
/**
* 当前余额
*/
private ThreadLocal<Integer> balance = ThreadLocal.withInitial(() -> 1000);
/**
* 存款
*
* @param money 存款金额
*/
public void deposit(int money) {
String threadName = Thread.currentThread().getName();
System.out.println(threadName + " -> 当前账户余额为:" + this.balance.get());
this.balance.set(this.balance.get() + money);
System.out.println(threadName + " -> 存入 " + money + " 后,当前账户余额为:" + this.balance.get());
}
>}
>------- Output --------
>Safe deposit
>Jasonkay -> 当前账户余额为:1000
>马化腾 -> 当前账户余额为:1000
>马云 -> 当前账户余额为:1000
>马云 -> 存入 200 后,当前账户余额为:1200
>Jasonkay -> 存入 200 后,当前账户余额为:1200
>马化腾 -> 存入 500 后,当前账户余额为:1500
>Not safe deposit
>Jasonkay -> 当前账户余额为:1000
>马化腾 -> 当前账户余额为:1200
>马云 -> 当前账户余额为:1000
>马云 -> 存入 200 后,当前账户余额为:1900
>马化腾 -> 存入 500 后,当前账户余额为:1700
>Jasonkay -> 存入 200 后,当前账户余额为:1200可见使用ThreadLocal保证了各线程分配各自的数据
而使用
private ThreadLocal<Integer> balance = ThreadLocal.withInitial(() -> 1000);创建则省去了先new再setValue的繁琐过程
ThreadLocal的API
ThreadLocal向外暴露出基本的增删改查方法,几个方法都是很简单:
通过get和set方法是访问和修改的入口,再通过remove方法移除值
| 方法 | 说明 |
|---|---|
| T get() | 返回此线程局部变量的当前线程副本中的值 |
| void set(T value) | 将此线程局部变量的当前线程副本中的值设置为指定值 |
| void remove() | 移除此线程局部变量当前线程的值 |
二. ThreadLocal源码分析(基于JDK11.0.4)
线性探测法
由于在ThreadLocalMap中数据存储采用的是线性探测法解决hash冲突, 所以在这里补充一下有关线性探测法的知识:
线性探测法是散列解决冲突的一种方法:
- 当hash一个关键字时,发现没有冲突,就保存关键字;
- 如果出现冲突,则就探测冲突地址下一个地址,依次按照线性查找,直到发现有空地址为止,从而解决冲突
例如: 关键字集合{7、8、30、11、18、9、14},散列函数为: H(key) = (key x 3) MOD 7, 设装填因子(元素个数/散列表长度)为0.7,那么散列表的长度为10
关键字(key)集合存放位置分别为:
| 7 | 8 | 30 | 11 | 18 | 9 | 14 |
|---|---|---|---|---|---|---|
| 0 | 3 | 6 | 5 | 5 | 6 | 0 |
由表格知道,这里的7和14、30和9、11和18出现了位置存放冲突。存放key=7时,散列表长度为10的表中其实没有冲突, 因为7是第一个存在到表中的key,所以一定不会有冲突的,所以7对应散列表的地址0;
8、30、11存放的地址分别是3、 6 、5,但是到了key=18时候,发现存放的地址为5,而地址5已经存放了key=11, 这时发生了地址冲突
根据线性探测法,算法会探测地址5的下一个地址,即地址6,而此时地址6已经存放了key=30,程序继续探测下一个地址,发现地址7位空,此时把key=18存放到地址7处。以此类推,最后得出的散列表为:
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|
| 7 | 14 | 8 | 11 | 30 | 18 | 9 |
成功查找率:(1+1+1+1+3+3+2)/ 7
不成功查找率:
计算查找不成功的次数就直接找关键字到第一个地址上关键字为空的距离即可, 但根据哈希函数地址为MOD7,因此初始只可能在0-6的位置。等概率情况下,查找0-6位置查找失败的查找次数为:
地址0,到第一个关键字为空的地址2的距离为3,因此查找不成功的次数为3.
地址1, 到第一个关键为空的地址2的距离为2,因此查找不成功的次数为2.
地址2, 到第一个关键为空的地址2的距离为1,因此查找不成功的次数为1.
地址3,到第一个关键为空的地址4的距离为2,因此查找不成功的次数为2.
地址4,到第一个关键为空的地址4的距离为1,因此查找不成功的次数为1.
地址5,到第一个关键为空的地址2(注意不是地址9,因为初始只可能在0~6之间,因此循环回去)的距离为5,因此查找不成功的次数为5.
地址6,到第一个关键为空的地址2(注意不是地址9,因为初始只可能在0~6之间,因此循环回去)的距离为4,因此查找不成功的次数为4.
不成功查找率:(3+2+1+2+1+5+4)/ 7
扩展: 在ThreadLocal中改进了线性探测
① ThreadLocal生成hashcode方法: nextHashCode()
2
>private static int nextHashCode() {return extHashCode.getAndAdd(HASH_INCREMENT);}从nextHashCode方法可以看出: ThreadLocal每实例化一次,其hash值就原子增加HASH_INCREMENT = 0x61c88647(选择原因后面解释)
② set方法解读
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
>public void set(T value) {
Thread t = Thread.currentThread();
ThreadLocalMap map = getMap(t);
if (map != null)
map.set(this, value);
else
createMap(t, value);
>}
>ThreadLocalMap getMap(Thread t) {
return t.threadLocals;
>}
>// threadLocalMap.set()
>private void set(ThreadLocal<?> key, Object value) {
Entry[] tab = table;
int len = tab.length;
int i = key.threadLocalHashCode & (len-1);
for (Entry e = tab[i]; e != null; e = tab[i = nextIndex(i, len)]) {
ThreadLocal<?> k = e.get();
if (k == key) {
e.value = value;
return;
}
if (k == null) {
replaceStaleEntry(key, value, i);
return;
}
}
tab[i] = new Entry(key, value);
int sz = ++size;
if (!cleanSomeSlots(i, sz) && sz >= threshold)
rehash();
>}ThreadLocal从当前线程Thread中获取ThreadLocalMap实例(ThreadLocal的内部类);
调用ThreadLocalMap的set()方法[实际set()的实现方法], 进行设置:
- 通过
hash & (len -1)定位到table的位置i,假设table中i位置的元素为f- 如果f != null,假设f中的引用为k:
- 如果k和当前ThreadLocal实例一致,则修改value值,返回;
- 如果k为null,说明这个f已经是stale(陈旧的)的元素。调用replaceStaleEntry方法删除table中所有陈旧的元素(即entry的引用为null)并插入新元素,返回
- 否则通过nextIndex方法找到下一个元素f,继续进行线性探索。 如果f == null,则把Entry加入到table的i位置中。 通过cleanSomeSlots删除陈旧的元素,如果table中没有元素删除,需判断当前情况下是否要进行扩容;
- 如果f == null,则把Entry加入到table的i位置中
- 通过cleanSomeSlots删除陈旧的元素,如果table中没有元素删除,需判断当前情况下是否要进行扩容
所以在ThreadLocal中的线性探索公式为:
index = hash & (len - 1), 并且hash = pre_hash + 0x61c88647(HASH_INCREMENT)顺便提一下: ThreadLocal中使用的是AtomicInteger存放nextHashCode, 所以每次增加是原子操作
阅读源码前的解读
另外, 在进行源码分析之前先纠正一个误区: 很多人以为ThreadLocal的内部维持了一个map,其中以当前线程作为键,传入的数据作为值来进行封装的,这个想法是错误的!
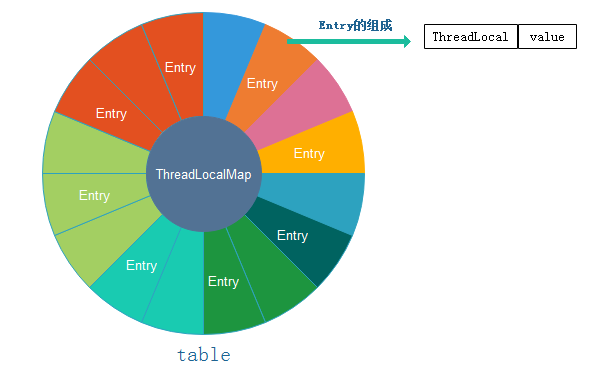
ThreadLocal的内部维护着一个叫做ThreadLocalmap的静态类,它由一个首尾闭合的动态数组组成(默认大小为16),每个数组都是一个Entry对象,该对象以ThreadLocal对象作为key,以传入的数据作为值进行封装而成.以下是TheadLocalMap的图示:
注意:
1. ThreadLocal类封装了set()、get()、remove()3个核心方法
2. 通过getMap()获取每个子线程Thread持有自己的ThreadLocalMap实例, 因此它们是不存在并发竞争的可以理解为每个线程有自己的变量副本
3. ThreadLocalMap中Entry[]数组存储数据,初始化长度16,后续每次都是2倍扩容(主线程中定义了几个变量,Entry[]才有几个key)
4.
Entry的key是对ThreadLocal的弱引用,当抛弃掉ThreadLocal对象时,垃圾收集器会忽略这个key的引用而清理掉ThreadLocal对象, 防止了内存泄漏
注释中的示例代码:
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
/**
* 每个线程都保持对线程本地变量的副本的隐式引用,
* 只要线程是活动的并且{@code ThreadLocal}实例是可访问的;
* 在线程离开之后,线程本地实例的所有副本都受到垃圾收集
*(除非存在对这些副本的其他引用)
*
* Each thread holds an implicit reference to its copy of a thread-local
* variable as long as the thread is alive and the {@code ThreadLocal}
* instance is accessible; after a thread goes away, all of its copies of
* thread-local instances are subject to garbage collection (unless other
* references to these copies exist).
*/
public class ThreadId {
// Atomic integer containing the next thread ID to be assigned
// 包含要分配的下一个线程ID的原子整数
private static final AtomicInteger nextId = new AtomicInteger(0);
// Thread local variable containing each thread's ID
// 包含每个线程ID的线程局部变量
private static final ThreadLocal<Integer> threadId =
new ThreadLocal<Integer>() {
protected Integer initialValue() {
return nextId.getAndIncrement();
}
};
// Returns the current thread's unique ID, assigning it if necessary
// 返回当前线程的唯一ID,必要时将其赋值
public static int get() {
return threadId.get();
}
}ThreadId类会在每个线程中生成唯一标识符。线程的id在第一次调用threadid.get()时被分配,在随后的调用中保持不变
ThreadId类利用AtomicInteger原子方法getAndIncrement为每个线程创建一个threadId变量,例如: 第一个线程是1,第二个线程是2…,并供一个类静态get方法用以获取当前线程ID
有一个注意点是:用户可以自定义initialValue()初始化方法,来初始化threadLocal的值
关于Entry对象
1 | //用虚引用封装的ThreadLocal |
该对象继承自弱引用WeakReference. 我们知道java中引用类分为4种,强度从大到小的排列顺序为:强引用、软引用、弱引用、虚引用。这样做的最大好处就是可以方便GC处理
其中关于弱引用: 具有弱引用的对象拥有更短暂的生命周期。在垃圾回收器线程扫描它所管辖的内存区域的过程中,一旦发现了只具有弱引用的对象,不管当前内存空间足够与否,都会回收它的内存。不过,由于垃圾回收器是一个优先级很低的线程,因此不一定会很快发现那些只具有弱引用的对象
下面进行源码解读:
1 | import jdk.internal.misc.TerminatingThreadLocal; |
三. 关于ThreadLocal源码中的一些问题
ThreadLocalMap到底存放在哪里
在Java 1.4之前,threadLocals会导致线程之间发生竞争。在新的设计里,每一个线程都有他们自己的ThreadLocalMap(在Thread类中以属性的方式定义, 并以懒加载的方式初始化),用来提高吞吐量,然而,我们仍然面临内存泄漏的可能性,因为长时间运行线程的ThreadLocalMap中的值不会被清除
在Java的早期版本中,threadLocals在多个线程进行访问的时候存在竞争问题,使得它们在多核应用程序中几乎无用。在Java 1.4中,引入了一个新的设计,设计者把threadLocals直接存储在Thread中。当我们现在调用ThreadLocal的get方法时,将会返回一个当前线程里的实例ThreadLocalMap(ThreadLocal的一个内部类)
当一个线程退出时,它会删除它ThreadLocal里的所有值。这发生在exit()方法中,垃圾回收之前,如果我们在使用ThreadLocal后忘记调用remove()方法,那么当线程退出后值还会存在
ThreadLocalMap包含了对ThreadLocal的弱引用以及值的强引用,但是,它并不会判断ReferenceQueue里面哪些弱引用的值已经被清除,因为Entry不可能立即从ThreadLocalMap中清除
threadLocal,threadLocalMap,entry之间的关系如下图所示:
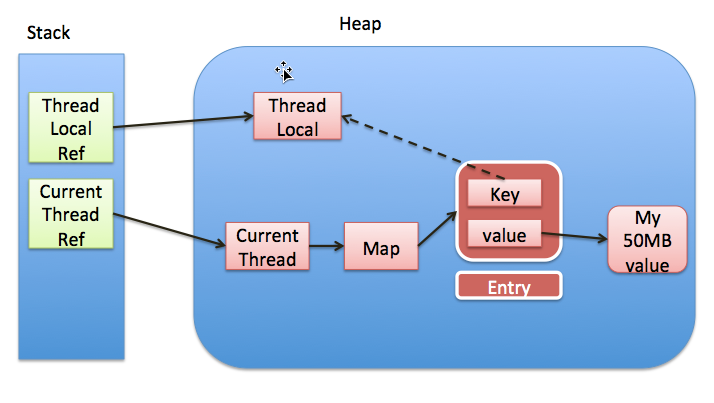
上图中,实线代表强引用,虚线代表的是弱引用
从线程Thread的角度来看,每个线程内部都会持有一个对ThreadLocalMap实例的引用,ThreadLocalMap实例相当于线程的局部变量空间,存储着线程各自的数据
综上所述:
ThreadLocalMap实例在JDK 1.4之后就存在于Thread类中, ThreadLocalMap的定义在ThreadLocal中以内部类的形式;
在使用时, ThreadLocal类似于工具类, 通过
Thread.currentThread()获取当前线程, 然后获取对应的threadLocals进行操作;实际存储线程本地副本的数据结构是ThreadLocalMap中定义的内部类Entry, ThreadLocalMap中定义的Entry[] 动态数组存放实际数据, 通过线性探测法
Entry[] 动态数组的大小初始化为16, 每次扩容翻倍(总是2的幂)
扩容的阈值由threshold提供, 通常为table大小的2/3, 但当size >= threshold时,遍历table并删除key为null的元素,此时如果删除后size >= threshold*3/4时,需要对table进行扩容
为什么使用0x61c88647进行Rehash操作
和通常的线性探测法进行线性的index增加不同, 在ThreadLocal中实际上hashcode每次增加魔数0x61c88647, 用来生成hashcode间隙, 并且官方给出的解释是: 可以让生成出来的值或者说ThreadLocal的ID较为均匀地分布在2的幂大小的数组中
1 | private static final int HASH_INCREMENT = 0x61c88647; |
可以看出,新的hashcode是在上一个被构造出的ThreadLocal的ID/threadLocalHashCode的基础上加上一个魔数0x61c88647的
实际上, 这个魔数的选取与斐波那契数列(黄金分割数)有关:
0x61c88647对应的十进制为1640531527, 斐波那契散列的乘数可以用(long) ((1L << 31) * (Math.sqrt(5) - 1))可以得到2654435769,如果把这个值给转为带符号的int,则会得到-1640531527
换句话说(1L << 32) - (long) ((1L << 31) * (Math.sqrt(5) - 1))得到的结果就是1640531527也就是0x61c88647
通过理论与实践,当我们用0x61c88647作为魔数累加为每个ThreadLocal分配各自的ID也就是threadLocalHashCode再与2的幂-1按位与,得到的结果分布很均匀
ThreadLocalMap使用的是线性探测法,均匀分布的好处在于很快就能探测到下一个临近的可用slot,从而保证了效率
下面通过一段代码来校验算法的散列性:
1 | /** |
根据运行结果,代表此算法在长度为2的N次方的数组上,确实可以完美散列
ThreadLocal源码中为了防止内存泄露做出的努力
以下文字转自: 一篇文章,从源码深入详解ThreadLocal内存泄漏问题
再看threadLocal,threadLocalMap,entry之间的关系图:
上图中,实线代表强引用,虚线代表的是弱引用,如果threadLocal外部强引用被置为null(threadLocalInstance=null)的话,threadLocal实例就没有一条引用链路可达,很显然在gc(垃圾回收)的时候势必会被回收, 因此entry就存在key为null的情况,而无法通过一个key为null去访问到该entry的value
同时,就存在了这样一条引用链:threadRef->currentThread->threadLocalMap->entry->valueRef->valueMemory, 导致在垃圾回收的时候进行可达性分析的时候, value可达! 从而不会被回收掉,但是该value永远不能被访问到,这样就存在了内存泄漏
当然,如果线程执行结束后,threadLocal,threadRef会断掉,因此threadLocal,threadLocalMap,entry都会被回收掉
可是,在实际使用中我们都是会用线程池去维护我们的线程,比如在Executors.newFixedThreadPool()时创建线程的时候,为了复用线程是不会结束的,所以threadLocal内存泄漏就值得我们关注!
实际上,为了解决ThreadLocal潜在的内存泄漏的问题,Josh Bloch and Doug Lea大师已经做了一些改进。在threadLocal的set和get方法中都有相应的处理。下文为了叙述,针对key为null的entry,源码注释为stale entry,直译为不新鲜的entry,这里我就称之为“脏entry”。比如在ThreadLocalMap的set方法中:
1 | private void set(ThreadLocal<?> key, Object value) { |
在ThreadLocalMap.set方法中针对脏entry做了这样的处理:
① 如果当前table[i] != null的话说明hash冲突就需要向后环形查找,若在查找过程中遇到脏entry就通过replaceStaleEntry进行处理;
② 如果当前table[i] == null的话说明新的entry可以直接插入,但是插入后会调用cleanSomeSlots方法检测并清除脏entry
cleanSomeSlots
1 | private boolean cleanSomeSlots(int i, int n) { |
入参:
① i的意义
插入entry的位置i,很显然在上述情况(table[i]==null)中,entry刚插入后该位置i很显然不是脏entry;
② 参数n的用途
主要用于扫描控制(scan control),从while中是通过n来进行条件判断的说明n就是用来控制扫描趟数(循环次数)的
在扫描过程中,如果没有遇到脏entry就整个扫描过程持续log2(n)次,log2(n)的得来是因为n >>>= 1,每次n右移一位相当于n除以2。如果在扫描过程中遇到脏entry的话就会令n为当前hash表的长度(n=len),再扫描log2(n)趟,注意此时n增加无非就是多增加了循环次数从而通过nextIndex往后搜索的范围扩大,示意图如下
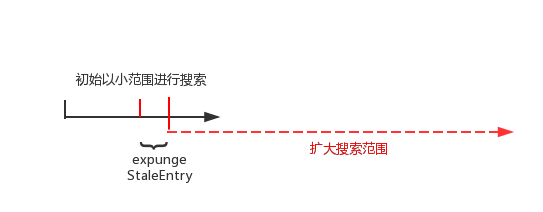
按照n的初始值,搜索范围为黑线,当遇到了脏entry,此时n变成了哈希数组的长度(n取值增大),搜索范围log2(n)增大,红线表示。如果在整个搜索过程没遇到脏entry的话,搜索结束,采用这种方式的主要是用于时间效率上的平衡
③ n的取值
如果是在set方法插入新的entry后调用,n位当前已经插入的entry个数size;如果是在replaceSateleEntry方法中调用n为哈希表的长度len
expungeStaleEntry
如果对输入参数能够理解的话,那么cleanSomeSlots方法搜索基本上就清除了,但是全部搞定还需要掌握expungeStaleEntry方法,当在搜索过程中遇到了脏entry的话就会调用该方法去清理掉脏entry。源码为:
1 | private int expungeStaleEntry(int staleSlot) { |
该方法主要做了这么几件事情:
① 清理当前脏entry,即将其value引用置为null,并且将table[staleSlot]也置为null。value置为null后该value域变为不可达,在下一次gc的时候就会被回收掉,同时table[staleSlot]为null后以便于存放新的entry;
② 从当前staleSlot位置向后环形(nextIndex)继续搜索,直到遇到哈希桶(tab[i])为null的时候退出;
③ 若在搜索过程再次遇到脏entry,继续将其清除。
也就是说该方法,清理掉当前脏entry后,并没有闲下来继续向后搜索,若再次遇到脏entry继续将其清理,直到哈希桶(table[i])为null时退出。因此方法执行完的结果为 从当前脏entry(staleSlot)位到返回的i位,这中间所有的entry不是脏entry。为什么是遇到null退出呢?原因是存在脏entry的前提条件是 当前哈希桶(table[i])不为null,只是该entry的key域为null。如果遇到哈希桶为null,很显然它连成为脏entry的前提条件都不具备。
现在对cleanSomeSlot方法做一下总结,cleanSomeSlot方法主要有这样几点:
① 从当前位置i处(位于i处的entry一定不是脏entry)为起点在初始小范围(log2(n),n为哈希表已插入entry的个数size)开始向后搜索脏entry,若在整个搜索过程没有脏entry,方法结束退出;
② 如果在搜索过程中遇到脏entryt通过expungeStaleEntry方法清理掉当前脏entry,并且该方法会返回下一个哈希桶(table[i])为null的索引位置为i。这时重新令搜索起点为索引位置i,n为哈希表的长度len,再次扩大搜索范围为log2(n’)继续搜索;
下面,以一个例子更清晰的来说一下,假设当前table数组的情况如下图:
如图当前n等于hash表的size即n=10,i=1,在第一趟搜索过程中通过nextIndex,i指向了索引为2的位置,此时table[2]为null,说明第一趟未发现脏entry,则第一趟结束进行第二趟的搜索
第二趟所搜先通过nextIndex方法,索引由2的位置变成了i=3,当前table[3]!=null但是该entry的key为null,说明找到了一个脏entry,先将n置为哈希表的长度len,然后继续调用expungeStaleEntry方法,该方法会将当前索引为3的脏entry给清除掉(令value为null,并且table[3]也为null),但是该方法可不想偷懒,它会继续往后环形搜索,往后会发现索引为4,5的位置的entry同样为脏entry,索引为6的位置的entry不是脏entry保持不变,直至i=7的时候此处table[7]位null,该方法就以i=7返回。至此,第二趟搜索结束;
由于在第二趟搜索中发现脏entry,n增大为数组的长度len,因此扩大搜索范围(增大循环次数)继续向后环形搜索;
直到在整个搜索范围里都未发现脏entry,cleanSomeSlot方法执行结束退出。
replaceStaleEntry
1 | private void replaceStaleEntry(ThreadLocal<?> key, Object value, int staleSlot) { |
首先先看这一部分的代码:
1 | int slotToExpunge = staleSlot; |
这部分代码通过PreIndex方法实现往前环形搜索脏entry的功能,初始时slotToExpunge和staleSlot相同,若在搜索过程中发现了脏entry,则更新slotToExpunge为当前索引i。另外,说明replaceStaleEntry并不仅仅局限于处理当前已知的脏entry,它认为在出现脏entry的相邻位置也有很大概率出现脏entry,所以为了一次处理到位,就需要向前环形搜索,找到前面的脏entry。那么根据在向前搜索中是否还有脏entry以及在for循环后向环形查找中是否找到可覆盖的entry,我们分这四种情况来充分理解这个方法:
① 前向有脏entry
1.1 后向环形查找找到可覆盖的entry
该情形如下图所示。
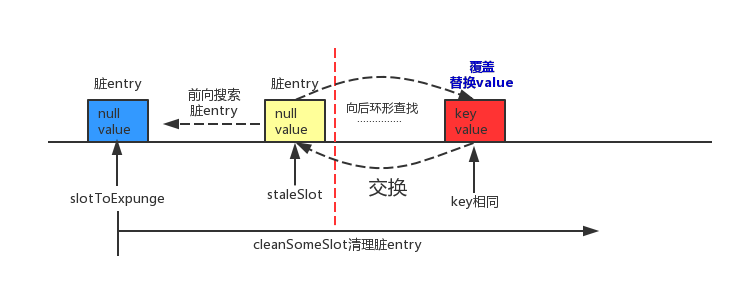
如图,slotToExpunge初始状态和staleSlot相同,当前向环形搜索遇到脏entry时,在第1行代码中slotToExpunge会更新为当前脏entry的索引i,直到遇到哈希桶(table[i])为null的时候,前向搜索过程结束。在接下来的for循环中进行后向环形查找,若查找到了可覆盖的entry,第2,3,4行代码先覆盖当前位置的entry,然后再与staleSlot位置上的脏entry进行交换。交换之后脏entry就更换到了i处,最后使用cleanSomeSlots方法从slotToExpunge为起点开始进行清理脏entry的过程
1.2 后向环形查找未找到可覆盖的entry
该情形如下图所示。
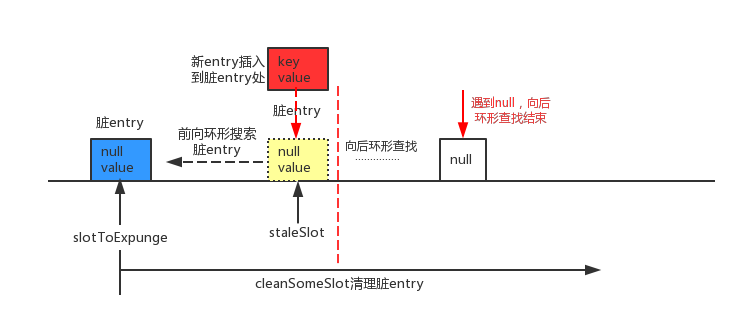
如图,slotToExpunge初始状态和staleSlot相同,当前向环形搜索遇到脏entry时,在第1行代码中slotToExpunge会更新为当前脏entry的索引i,直到遇到哈希桶(table[i])为null的时候,前向搜索过程结束。在接下来的for循环中进行后向环形查找,若没有查找到了可覆盖的entry,哈希桶(table[i])为null的时候,后向环形查找过程结束。那么接下来在8,9行代码中,将插入的新entry直接放在staleSlot处即可,最后使用cleanSomeSlots方法从slotToExpunge为起点开始进行清理脏entry的过程
② 前向没有脏entry
2.1 后向环形查找找到可覆盖的entry
该情形如下图所示。
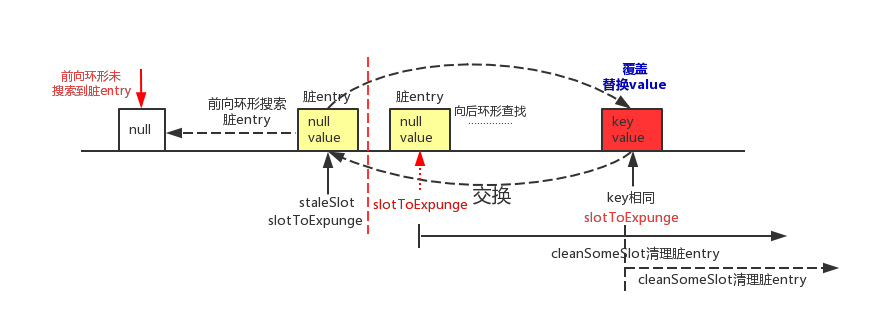
如图,slotToExpunge初始状态和staleSlot相同,当前向环形搜索直到遇到哈希桶(table[i])为null的时候,前向搜索过程结束,若在整个过程未遇到脏entry,slotToExpunge初始状态依旧和staleSlot相同。在接下来的for循环中进行后向环形查找,若遇到了脏entry,在第7行代码中更新slotToExpunge为位置i。若查找到了可覆盖的entry,第2,3,4行代码先覆盖当前位置的entry,然后再与staleSlot位置上的脏entry进行交换,交换之后脏entry就更换到了i处。如果在整个查找过程中都还没有遇到脏entry的话,会通过第5行代码,将slotToExpunge更新当前i处,最后使用cleanSomeSlots方法从slotToExpunge为起点开始进行清理脏entry的过程
2.2 后向环形查找未找到可覆盖的entry
该情形如下图所示
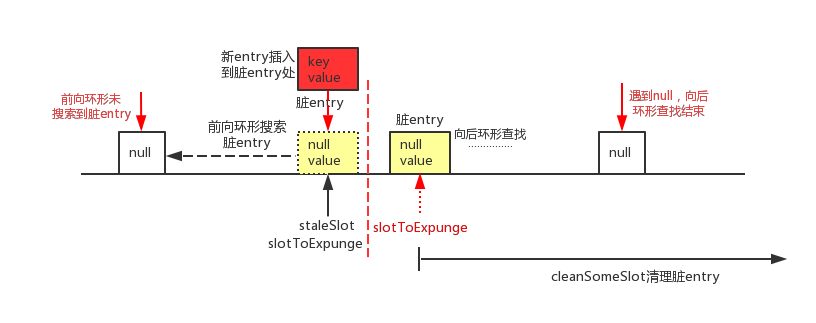
如图,slotToExpunge初始状态和staleSlot相同,当前向环形搜索直到遇到哈希桶(table[i])为null的时候,前向搜索过程结束,若在整个过程未遇到脏entry,slotToExpunge初始状态依旧和staleSlot相同。在接下来的for循环中进行后向环形查找,若遇到了脏entry,在第7行代码中更新slotToExpunge为位置i。若没有查找到了可覆盖的entry,哈希桶(table[i])为null的时候,后向环形查找过程结束。那么接下来在8,9行代码中,将插入的新entry直接放在staleSlot处即可。另外,如果发现slotToExpunge被重置,则第10行代码if判断为true,就使用cleanSomeSlots方法从slotToExpunge为起点开始进行清理脏entry的过程
下面用一个实例来有个直观的感受,示例代码就不给出了,代码debug时table状态如下图所示:
如图所示,当前的staleSolt为i=4,首先先进行前向搜索脏entry,当i=3的时候遇到脏entry,slotToExpung更新为3,当i=2的时候tabel[2]为null,因此前向搜索脏entry的过程结束。然后进行后向环形查找,知道i=7的时候遇到table[7]为null,结束后向查找过程,并且在该过程并没有找到可以覆盖的entry。最后只能在staleSlot(4)处插入新entry,然后从slotToExpunge(3)为起点进行cleanSomeSlots进行脏entry的清理
补充:
当我们调用threadLocal的get方法时,当table[i]不是和所要找的key相同的话,会继续通过threadLocalMap的 getEntryAfterMiss方法向后环形去找
当我们调用threadLocal.remove方法时候,实际上会调用threadLocalMap的remove方法
从以上set,getEntry,remove方法看出,在threadLocal的生命周期里,针对threadLocal存在的内存泄漏的问题,都会通过expungeStaleEntry,cleanSomeSlots,replaceStaleEntry这三个方法清理掉key为null的脏entry
使用弱引用
从文章开头通过threadLocal,threadLocalMap,entry的引用关系看起来threadLocal存在内存泄漏的问题似乎是因为threadLocal是被弱引用修饰的。那为什么要使用弱引用呢?
假设threadLocal使用的是强引用,在业务代码中执行threadLocalInstance==null操作,以清理掉threadLocal实例的目的,但是因为threadLocalMap的Entry强引用threadLocal,因此在gc的时候进行可达性分析,threadLocal依然可达,对threadLocal并不会进行垃圾回收,这样就无法真正达到业务逻辑的目的,出现逻辑错误
假设Entry弱引用threadLocal,尽管会出现内存泄漏的问题,但是在threadLocal的生命周期里(set,getEntry,remove)里,都会针对key为null的脏entry进行处理。
从以上的分析可以看出,使用弱引用的话在threadLocal生命周期里会尽可能的保证不出现内存泄漏的问题,达到安全的状态。
Thread.exit()方法
当线程退出时会执行exit方法:
1 | private void exit() { |
从源码可以看出当线程结束时,会令threadLocals=null,也就意味着GC的时候就可以将threadLocalMap进行垃圾回收,换句话说threadLocalMap生命周期实际上thread的生命周期相同
在使用ThreadLocal时防止内存泄漏你应该做出的努力
之所以有关于内存泄露的讨论是因为在有线程复用如线程池的场景中,一个线程的寿命很长,大对象长期不被回收影响系统运行效率与安全。如果线程不会复用,用完即销毁了也不会有ThreadLocal引发内存泄露的问题
当我们仔细读过ThreadLocalMap的源码,我们可以推断,如果在使用的ThreadLocal的过程中,显式地进行remove是个很好的编码习惯,这样是不会引起内存泄漏
如果必须使用ThreadLocal,请确保在完成该操作后立即删除该值,并且最好在将线程返回到线程池之前
最佳做法是使用remove()而不是set(null),因为使用remove()将会使WeakReference立即被删除,并与值一起被删除
综上:
- 每次使用完ThreadLocal,都调用它的remove()方法,清除数据
- 在使用线程池的情况下,没有及时清理ThreadLocal,不仅是内存泄漏的问题,更严重的是可能导致业务逻辑出现问题。所以,使用ThreadLocal就跟加锁完要解锁一样,用完就清理
四. ThreadLocal实例
用ThreadLocal解决SimpleDateFormat的线程不安全的问题
SimpleDateFormat是一个线程不安全的格式化日期类, 创建一个SimpleDateFormat实例的开销比较昂贵,解析字符串时间时频繁创建生命周期短暂的实例导致性能低下
即使将SimpleDateFormat定义为静态类变量,貌似能解决这个问题,但是SimpleDateFormat是非线程安全的,同样存在问题,如果用synchronized线程同步同样面临问题,同步导致性能下降(线程之间序列化的获取SimpleDateFormat实例)
ThreadLocal解决了此问题,对于每个线程SimpleDateFormat不存在影响他们之间协作的状态,为每个线程创建一个SimpleDateFormat变量的拷贝:
1 | import java.text.DateFormat; |
使用ThreadLocal实现数字自增
1 | /** |
可以看出每个线程都产生出了5个数字。他们互不影响,线程运行的顺序可能有会不同,但是每个都是独立的,以当前线程作为键,值作为value,每个数字产生器都生成了独立的数字,达到了线程独立的效果