
紧接着上一部分,这部分将深度分析HashMap中的TreeNode内部类(它是实现HashMap等链表和红黑树数据结构的类), 然后再回到HashMap中讲述HashMap中的问题, 以及HashMap的使用:
- 数据结构Tree的发展史
- HashMap中TreeNode的源码分析
- HashMap中的hash冲突
- HashMap中的Rehash操作
- HashMap遍历方式(整表遍历, 并发遍历)
零. 数据结构Tree
树
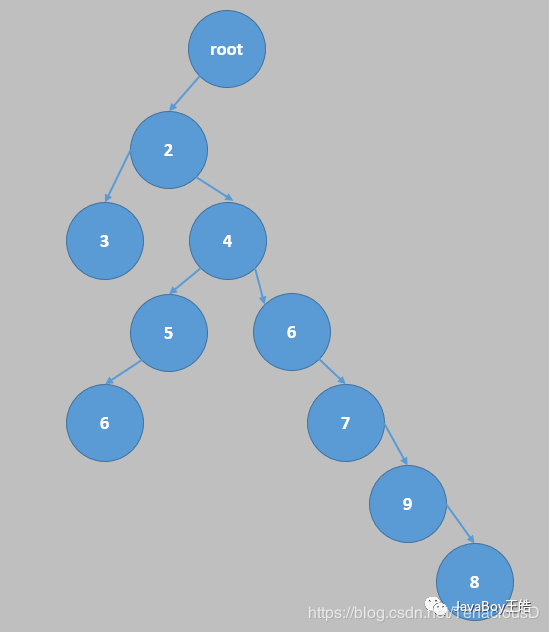
上图是一个简单的树形结构,最顶层为一个根节点,向下延伸出树杈和叶子构成一个具有层次关系的集合,例如前端树形插件Ztree
叶子节点: 一个节点也是一颗树,这个节点就是root根节点,上图中3,6和8没有下级节点,这种节点被称为叶子节点
任何一个节点下有子节点则构成子树。根节点没有父节点,叶子节点没有子节点,除了根节点没有父节点外其他的节点都只有一个父节点。任何节点可以有n的子节点
从某一个节点出发,到叶子节点的最少边数为该节点的高度(度). 例如,root节点的高度为5,2的高度为1,因为到最近的叶子节点3的边数为1, 4的高度为2
从root节点出发到某一个节点的边数为该节点的深度: 例如,root的深度为0, 2的深度为1, 5的深度为3
以上就是最基础的树形结构,以此为基础,我们继续向后延伸
二叉树
每个节点至多有两个子节点的树叫做二叉树
平衡二叉树
平衡二叉树在二叉树的基础上添加了新的限制,即树的左右高度之差小于等于1
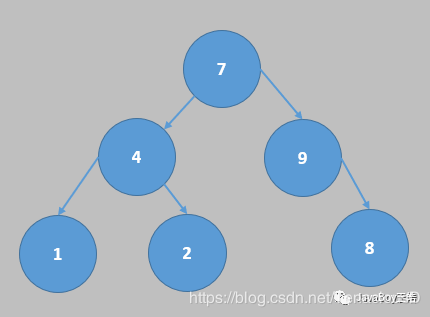
以7节点为准,左侧高度7到1叶子节点高度为2,7到8的叶子节点高度为2相等,高度差为0,节点4同理左右各两条边高度差为0,节点9左右高度差为1小于等于1,所以上图为一棵标准平衡二叉树
二叉查找树
二叉查找树(Binary Search Tree),又称二叉排序树(Binary Sort Tree),亦称二叉搜索树
二叉查找树在平衡二叉树的基础上继续添加了限制,但是会由于不断增加和删除节点失去平衡特性
首先我们先看一下增加了什么限制:
- 若左子树不空,则左子树上所有节点的值均小于它的根节点的值
- 若右子树不空,则右子树上所有节点的值均大于它的根节点的值
查找: 为简单的判断查找值比节点小的向左,比节点值大的向右,直到找到数据或者查到叶子节点还没有找到。查找平均复杂度为O(log n)
添加与删除节点: 树的结构通常不是一次生成的,而是在查找过程中,当树中不存在关键字等于给定值的结点时再进行插入。新插入的结点一定是一个新添加的叶子结点,并且是查找不成功时查找路径上访问的最后一个结点的左子或右子结点。
不断的添加与删除容易使平衡查找树失去平衡,所以为了保持平衡性,后面又诞生了很多新的算法树
AVL树
本身首先是一棵二叉查找树,但又与二叉查找树不同,AVL树是最先发明的自平衡二叉查找树,本质上是带了平衡功能的二叉查找树
AVL树的增加与删除节点与普通二叉查找树不同,它是以旋转使树重新达到平衡。分为右旋(顺时针)与左旋(逆时针)两种操作

右旋以某个节点为中心上图为15,将17向右沉入其右子节点位置,节点15变为新的根节点,15原右子节点变为17的左子节点

左旋为逆时针,以某个基点为中心例如上图18节点,将17节点其沉入其右子节点的位置,18作为新的根节点其原来的左子节点变为17的右子节点
以上为单纯的旋转,接下来我们看一下添加节点时如何变化
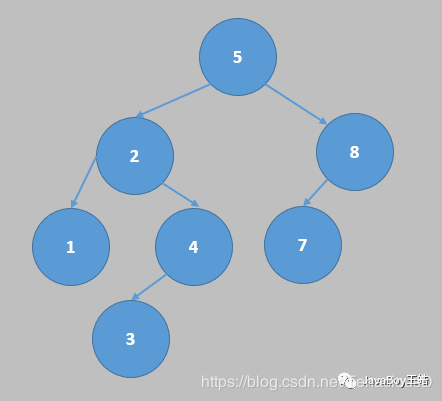
这是一个AVL树,当我们要添加节点6时如下图
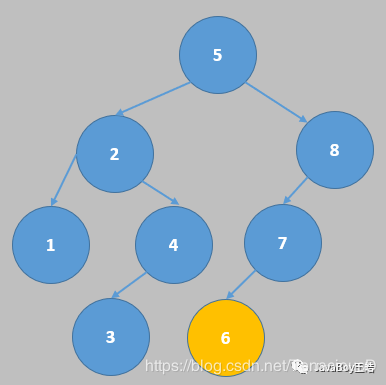
首先根据普通规则比5大,向右,比8小向左,比7小且7位叶子节点,6被新建到7的左子节点。但是这样8节点下的子树会失去平衡,这时AVL自平衡会开始旋转来使其达到平衡
以7为中心节点,将8沉入其右子节点位置,7变为子树的根节点,如下图
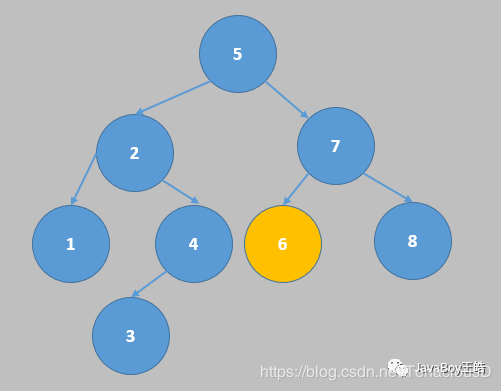
通过单次旋转就又使树达到了平衡
从AVL树中删除可以通过把要删除的节点向下旋转成一个叶子节点,接着直接剪除这个叶子节点来完成
红黑树
红黑树(Red Black Tree) 是一种自平衡二叉查找树,在1972年由Rudolf Bayer发明的,当时被称为平衡二叉B树(symmetric binary B-trees)。后来,在1978年被 Leo J. Guibas 和 Robert Sedgewick 修改为如今的“红黑树”
红黑树和AVL树类似,都是在进行插入和删除操作时通过特定操作保持二叉查找树的平衡,从而获得较高的查找性能,它可以在O(log n)时间内做查找,插入和删除
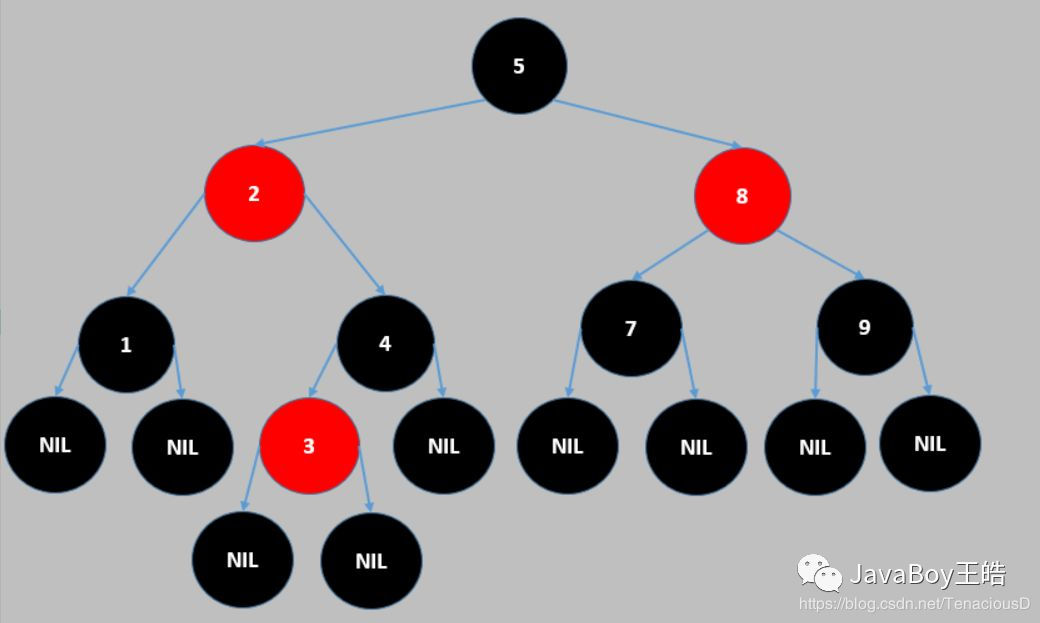
相对于二叉查找树,红黑树又添加了以下限制:
- 每个树节点会被染色,每个节点只能是红色或者黑色
- 根节点一定是黑色的
- nil节点为黑色,nil节点为所有叶子节点的虚拟子节点
- 不可出现父子节点都为红色的情况
- 从某一个节点到该节点的子孙节点的所有路径上包含相同数目的黑节点
补充:
- nil是一个对象值,如果要把一个对象设置为空的时候就用nil
- Nil是一个类对象的值,如果要把一个Class类型的对象设置为空的时候就用Nil
- NULL是一个通用指针
以上约束条件保证了之前说的增删查的复杂度均在O(log n)级别。第五点也是保证子树平衡的关键
一. HashMap中TreeNode的源码分析
HashMap使用数组: Node[] 存储TreeNode的形式作为数据的存储结构,故要掌握HashMap需要先看懂TreeNode:
HashMap中的TreeNode源码如下(建议在看源码之前先看下面各章的总结, 便于理解):
1 | /** |
二. HashMap中hash冲突的解决(Rehash)
JDK8中的HashMap相对JDK7中的HashMap做了些优化
首先,有一个问题:假如我们现在有一个容量为16的数组,现在我想往里面放对象,我有16个对象, 怎么放进去呢?
其实要解决一个问题就够了:对象要放在哪个下标?当然最简单的方法是从0下标开始一个一个挨着往后放
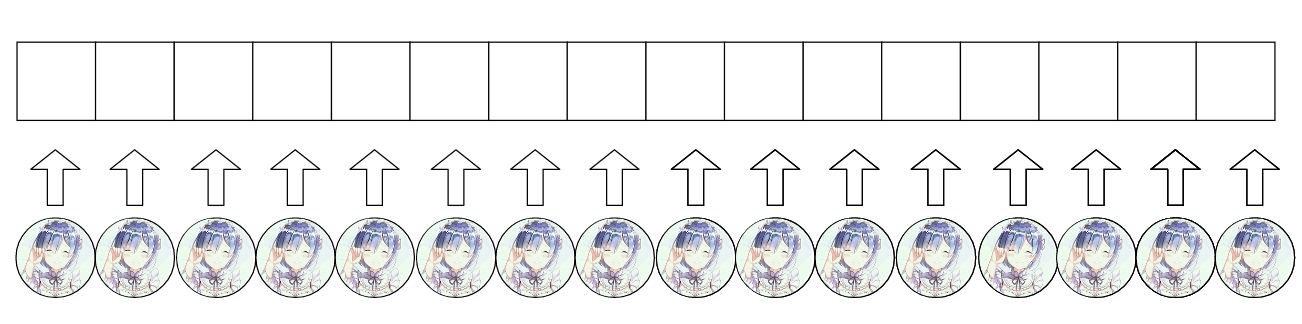
这样就把你们的对象放满整个数组了,一个位置也没有浪费~
但是有17个对象呢?
无论无何必须有两个对象在同一个槽位(槽位指的是数组中某个下标的空间)了,如果不扩充数组的大小的话
那我们采取的策略最简单的是像上面一样先塞满数组,最后一个对象随机放到一个位置,用链表的形式把他挂在数组中某个位置的对象上
(较新版本的JDK中 如果链表太长会变成树)
但是如果现在我们有20个对象呢???50个对象呢???100个,1000个对象呢???
每个槽位需要承受的对象数量会越来越多,如果只是一味地挂对象,而不采取合适的策略确定要加上去的对象到底放在哪个位置的话,很有可能出现下面这种状况
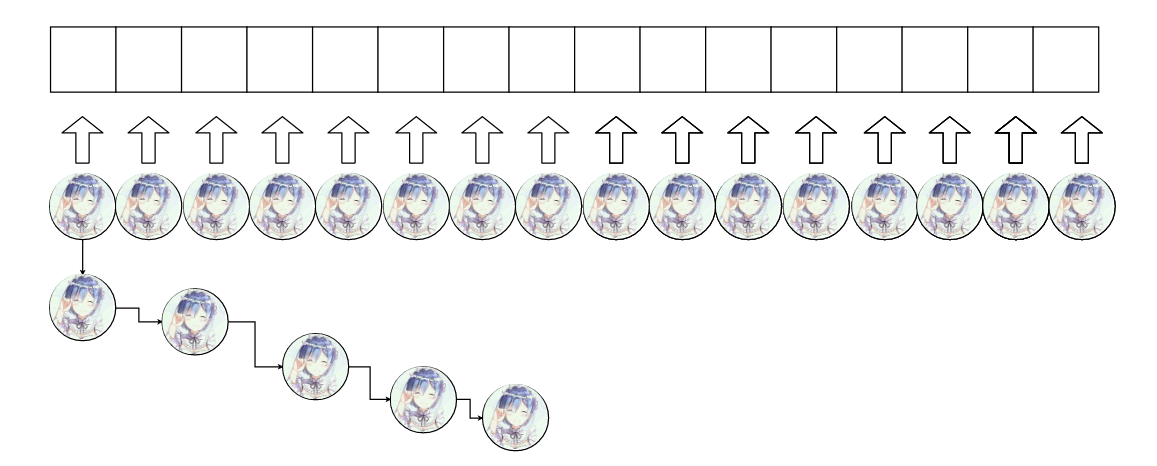
那么当我们查找一个对象的时候可能遇到这种情况,
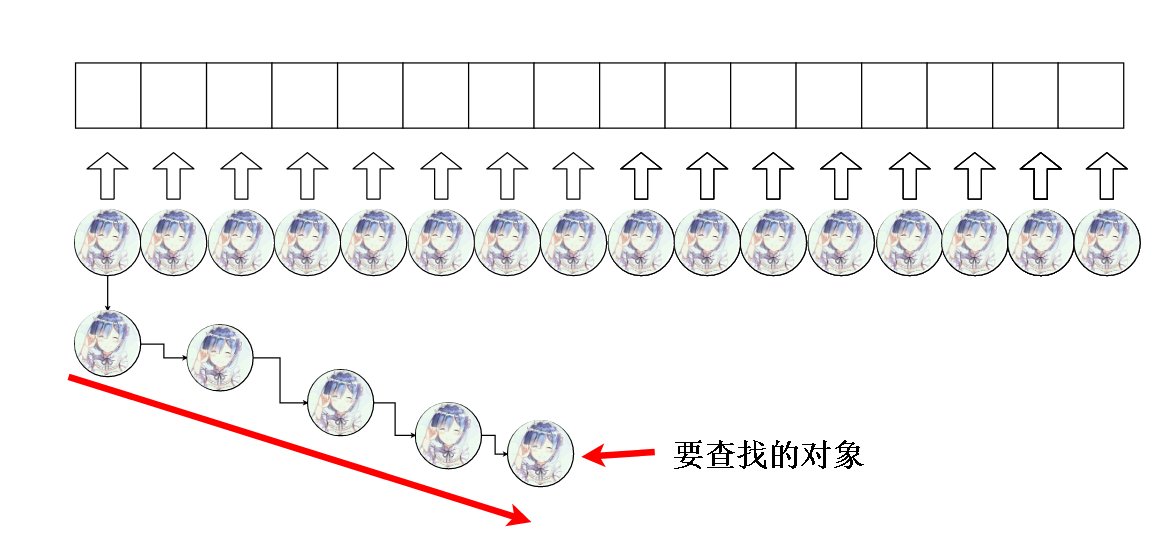
这样的话,查询时间复杂度为线性, 效率十分低下,我们希望加上去的对象在整个数组上呈均匀分布的趋势,这样就不会出现某个槽承受了很多对象但是有的槽位承受很少对象,甚至只有一个对象的情况
下面是我们希望的结果。
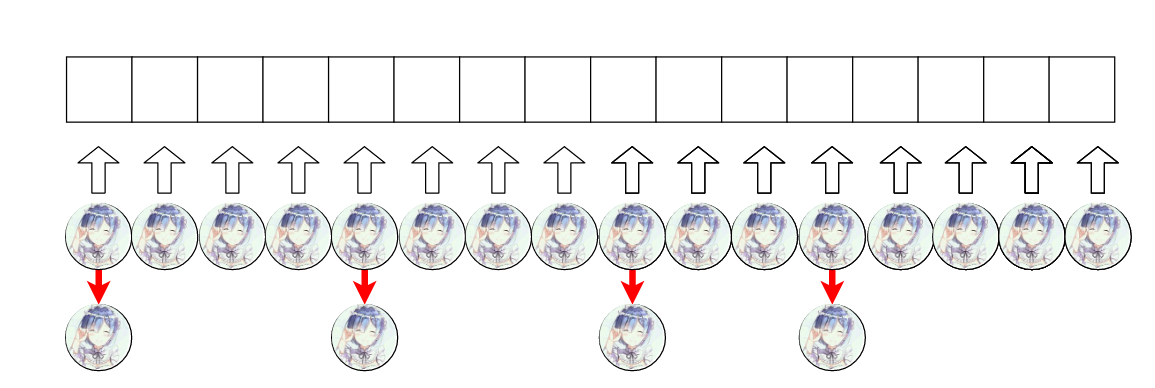
因为要查询的话最多查两次就能查到我们想要的对象了。
这样我们就不得不决定,要加入的对象在数组的下标了!
怎么确定下标呢?有一种确定下标的方法,这种确定下标的方法(算法)叫做散列
散列的过程就是通过对象的特征,确定他应该放在哪个下标的过程
那这个特征是什么呢???哈希码!(hashCode的翻译)
java每个对象都有一个叫”hashCode”的标签码 和他对应,当然这个hashCode不一定是唯一的
小贴士:
在HashMap的源码中调用了key.hashCode()来获得hashCode,请注意,因为实际调用到的是运行时对象所属类的方法
比如类A继承了类Object,A重写了Object的hashCode()方法,Object ob = new A(); ,ob.hashCode();调用的实际是类A重写后的hashCode方法
所以我们可以通过重写 hashCode() 方法来返回我们想要的hashCode值
所以不同对象的hashCode 可能是一样的,取决于类怎么重写hashCode()
我们的问题可以简化为,怎么把我们的hashCode映射到下标的二进制码上呢?
现在假设我们的 hashCode 是8位的 (实际上是32位的),比如下面就是一个对象a 的hashCode
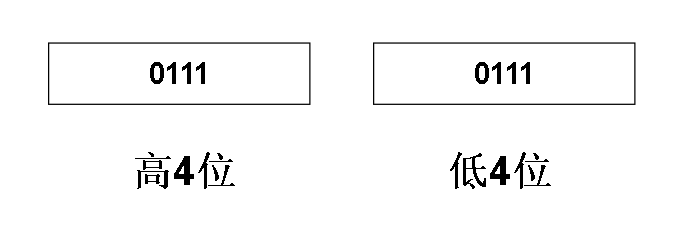
假如我们的数组大小是16,那么我们要根据hashCode 确定好数组下标,下标的范围是0~15.
该怎么确定呢?我们可以用直接映射的方法
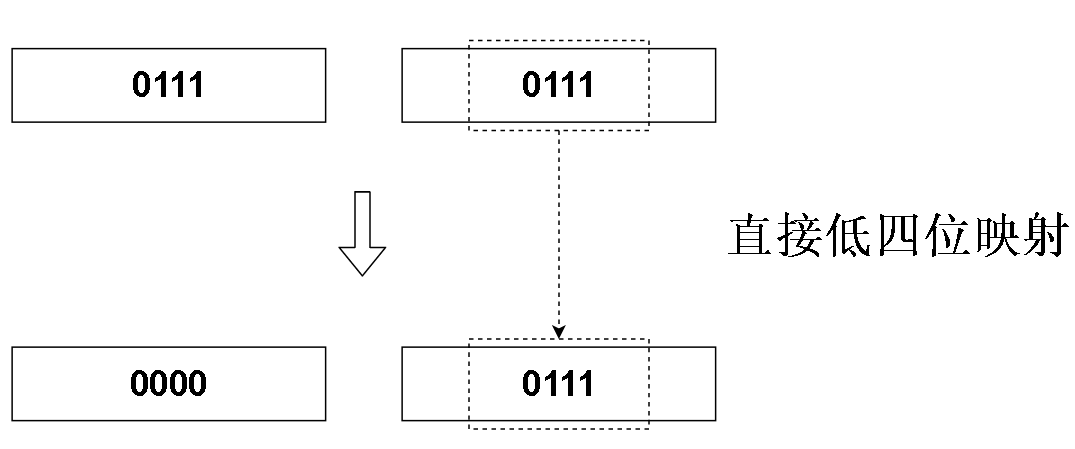
我们发现,把hashCode 的二进制码直接映射到数组下标的二进制码上,直接把高位全部置为0
而且因为我们用低四位去映射,所以范围会保持在0~15间,所以最后映射的结果总是没有超出范围
这样的话,上图的hashCode 的数组下标就是 7( 1 + 2 + 4 = 7, 0111的十进制=7)
但是,进一步观察,我们发现,无论高位怎么样,只要低位相同,都会映射到同一个数组下标上:
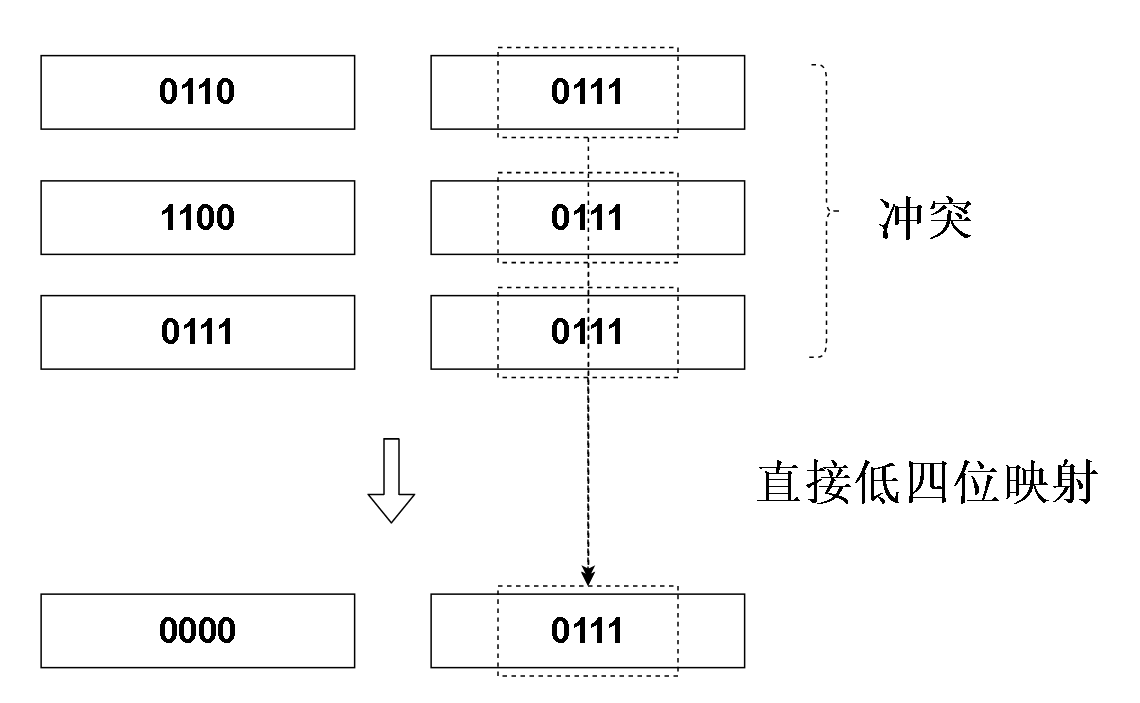
高位有 2 ^ 4 = 16 种情况,这16种情况都会瞄准同一个数组下标,何况实际上我们的hashCode是32位的,这样的话就有 2 ^ (32 - 4) = 2 ^ 28 种冲突
出现了我们之前担心的场景,许多甚至所有对象组成一条链表挂在一个位置上,这样查询效率十分低下。
这种对不同对象进行散列,但是最后得到的下标相同的情况称为hash冲突,也可以称为散列冲突,其实散列就是hash翻译过来的。
我们来看看JDK8中的HashMap是怎么解决这种冲突的
首先我们要知道,JDK8是怎么执行散列的
JDK8使用了掩码,即是下文注释中将提到的用来masking的数值
这个掩码是根据HashMap存储对象的数组的大小决定的,图中table就是我们所说的hash表,n - 1 被作为掩码和 传进来的hash值(也就是hashCode)
进行 & 运算:
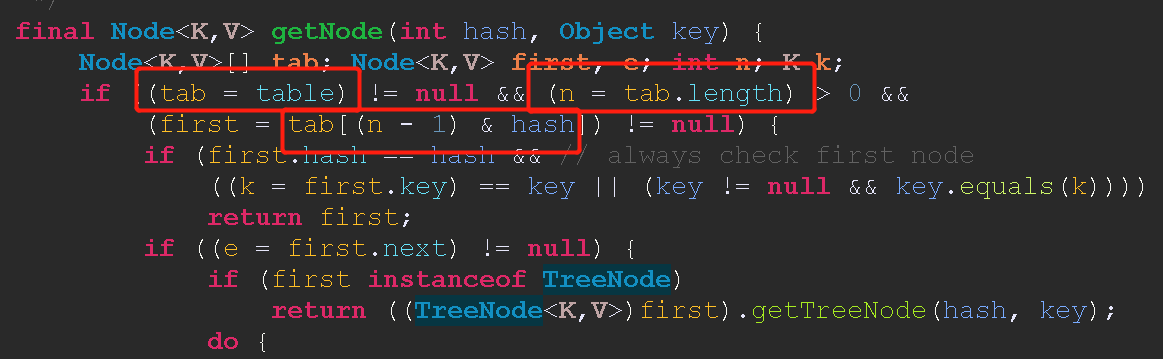
看下面一个例子更明了一点:
比如大小为 32 的hash表
32的二进制数是 0010 0000
那么32 - 1 = 31 就是 0001 1111
0001 1111 & A 会得到什么呢,0001 1111 像一块掩布一样,将和他 & 的数 A 的前三位都遮住,全部变成0,其他位不变,所以被称为掩码。
比如 A = 1101 0101
因为我们的掩码前三位全是0 那么他就会把A的前三位全部掩盖掉,掩码后面的1,和A对应位 & 之后保持不变
现在再来看看官方源码的hashCode是怎么减少冲突的。
来看hash 方法上的一段注解, hash方法是把hashCode再散列一次,把散列hashCode后的值作为返回值返回,以此再次减少冲突,而过程是把高位的特征性传到低位。
每个 [] 中的内容都是对前面一小段的解释,如果嫌麻烦可以直接读解释,不读英文
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
* Computes key.hashCode() and spreads (XORs) higher bits of hash
* to lower. Because the table uses power-of-two masking, sets of
* hashes that vary only in bits above the current mask will
* always collide. (Among known examples are sets of Float keys
* holding consecutive whole numbers in small tables.)
* So we apply a transform that spreads the impact of higher bits
* downward. There is a tradeoff between speed, utility, and
* quality of bit-spreading. Because many common sets of hashes
* are already reasonably distributed (so don't benefit from
* spreading), and because we use trees to handle large sets of
* collisions in bins, we just XOR some shifted bits in the
* cheapest possible way to reduce systematic lossage, as well as
* to incorporate impact of the highest bits that would otherwise
* never be used in index calculations because of table bounds.
*/hash再散列方法
计算key.hashCode()[计算得出hashCode 不属于这个hash函数管]把高位二进制序列(比如 0110 0111 中的 0110) , 的特征性传播到低位中,通过异或运算实现
因为HashMap存储对象的数组容量经常是2的次方,这个二的次方(比如上面是16 = 2 ^ 4) 减1后作为掩码
在掩码是2^n - 1 的情况下,只用低位的话经常发生hash冲突
(经典的例子是: 一组在小表中保存连续的浮点数key)
所以我们应用一个转换,将高位的影响向下传播
但是这种特性的传播会带来一定的性能损失(速度、实用性和位传播质量之间权衡)
因为有的hashCode他们的低位已经足够避免多数hash冲突了(已经被合理的均匀分布了, 他们在位传播的过程中不会受益)
[比如我们的hashCode是八位的并且我们的数组大小是((2 ^ 8) - 1) (0111 1111) ]
[那么只有两种冲突情况而已,0mmm mmmm 和 1mmm mmmm 会冲突,每次进行插入元素或者查找元素都要调用hash函数再一次散列hashCode,显然不划算]
因为我们使用树来处理容器中的大量冲突,所以我们只是以最节省的方式对一些移位的位进行异或运算,以减少系统损失
并合并最高位的影响,否则由于表边界的原因,最高位永远不会用于索引计算
1 | static final int hash(Object key) { |
什么意思呢?什么叫做把高位的特征也用上?
比如我们之前说的。当我们有一个大小为16的数组,下面是两个对象的hashCode
0110 0111
1100 0111
如果我们直接用这两个未经hash函数处理的hashCode 通过JDK的方法得出下标:
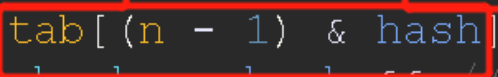
n = 16
16 = 0001 0000
16 - 1 = 15 = 0000 1111
hash(这是上图蓝字变量) = hashCode(未经hash函数再散列)
0110 0111 & 0000 1111 = 0000 0111 —— 7
1100 0111 & 0000 1111 = 0000 0111 —— 7
求得同一个下标,显然冲突了,就算两个hashCode他们的高位不同,但还是会冲突
现在我们用上高位的特性,
1 | static final int hash(Object key) { |
因为本来hashCode是32位的,所以上面 >>> 的是16,也就是高一半的位移到低一半去
而我们设置的hashCode 是8位的,所以上面的 >>> 的应该是 4
hash (上面蓝字变量) = hash (hashCode) —— hash函数对hashCode 再散列
对应过程如下图
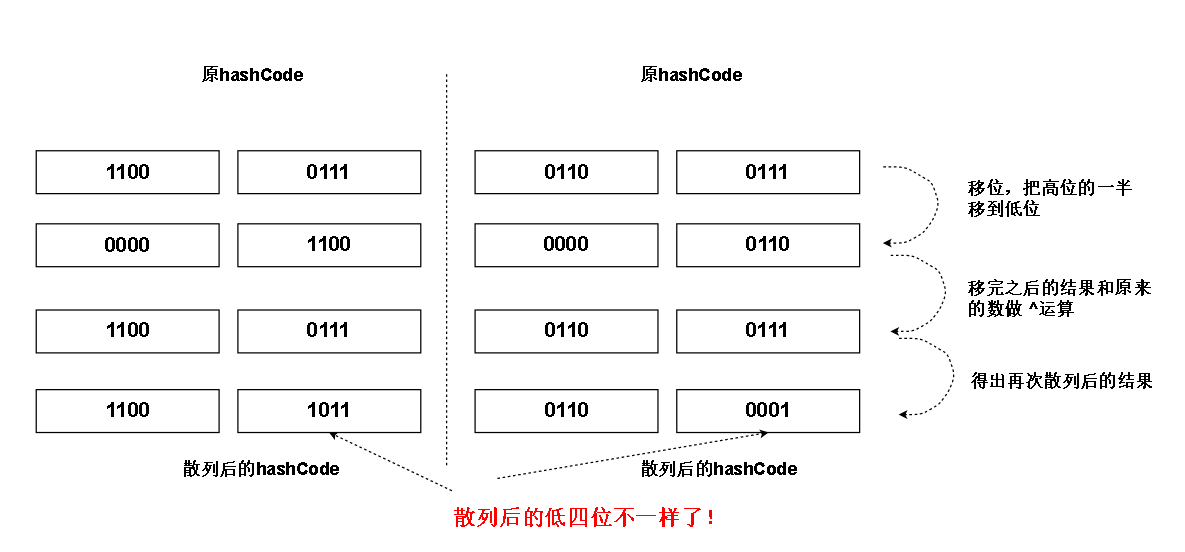
正如我们所见,原本冲突的低四位,把高位的特征传到他们上面后,他们不冲突了!
当我们对这些再散列后的结果用掩码掩掉不必要的高位之后(见上面的红框框图)(比如高四位),剩下的是
0000 1011
0000 0001
对应的数组下标是 11 和 1
解决了冲突!
三. HashMap遍历方式(整表遍历, 子列表遍历, 并发遍历)
全表遍历
遍历键值对
- 第一步:根据entrySet()获取HashMap的“键值对”的Set集合
- 第二步:通过Iterator迭代器遍历“第一步”得到的集合
1 | Set<Map.Entry<Integer, String>> entrySet = map.entrySet(); |
备注: map.entrySet()方法获取到的是一个包括所有Map.Entry对象的Set
遍历键
- 第一步:根据keySet()获取HashMap的“键”的Set集合
- 第二步:通过Iterator迭代器遍历“第一步”得到的集合
1 | Set<Integer> entrySet = map.keySet(); |
备注: map.keySet()方法获取到的是一个包括所有Key泛型类型的对象的Set
遍历值
- 第一步:根据value()获取HashMap的“值”的集合
- 第二步:通过Iterator迭代器遍历“第一步”得到的集合
1 | Collection<String> values = map.values(); |
备注: map.values()获取到的是一个包括所有value泛型类型的对象的Collection(允许重复)
遍历测试程序如下:
1 | /** |
小贴士: 阿里巴巴开发规范中提到, 如果需要遍历k-v对, 一定使用entrySet()方法获取Entry遍历
使用keySet()遍历map的效率较低
并发遍历
在JDK 8之后加入了Spliterator接口帮助进行并发遍历, map中有KeySpliterator, ValueSpliterator和EntrySpliterator都继承自内部抽象类HashMapSpliterator并实现了Spliterator接口, 因此可以通过这三个内部类获取相应的Spliterator来完成并发遍历HashMap
例: 创建一个长度为100的list,如果下标能被10整除,则该位置数值跟下标相同,否则值为aaaa。然后多线程遍历list,取出list中的数值(字符串aaaa不要)进行累加求和
1 | public class Test { |
注: HashMap的遍历和ArrayList有很大的不同!
由于HashMap中的遍历涉及到桶(存储分区数目)以及树(或者链表)结构, 且和具体数据的hash值也有很大的关系
所以可能会出现像上例中Thread-0类似: 做了切分但实际上没有分配任何数据!
HashMap由于结构十分复杂, 以后有机会再研究内部的并发实现